Modèles IA : vraie innovation ou marketing ?
GPT-5.5, Claude Opus 5, Gemini 3.1 : un nom de modèle toutes les deux semaines. Vraies révolutions ou marketing pour justifier des prix ? L'analyse chiffrée et la méthode pour choisir sans surpayer.
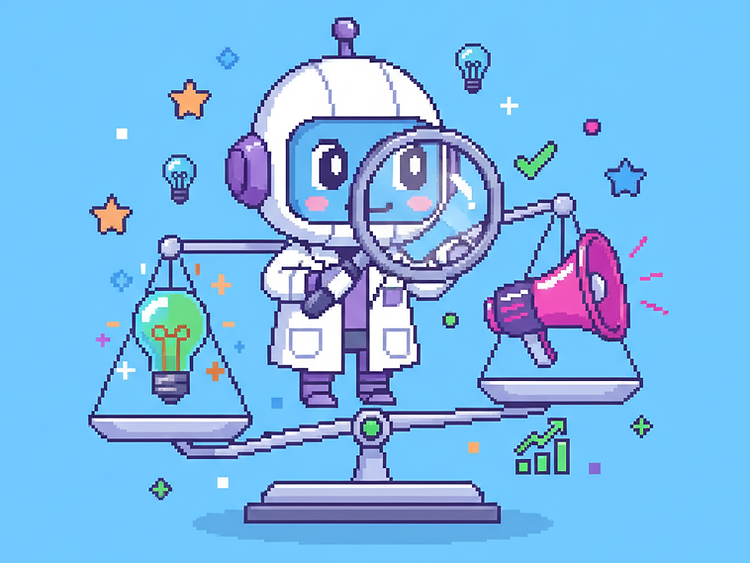
Un nouveau nom de modèle d'IA toutes les deux ou trois semaines : vraie avancée ou marketing tarifaire ? L'analyse chiffrée du marché 2026 et la méthode pour choisir sans surpayer.
1. Nouveaux modèles d'IA toutes les semaines : l'inflation des noms
Côté OpenAI, GPT-5 a succédé à GPT-4, puis GPT-5.1, GPT-5.4 et GPT-5.5. Côté Anthropic, Claude Opus 4.5, 4.6, 4.7, 4.8, puis Opus 5 en juillet 2026. Côté Google, Gemini 3, 3.1, 3.2, et déjà une Gemini 3.5 Pro en prévisualisation limitée. En dix-huit mois, les laboratoires ont imposé à l'IA un rythme de lancements qu'aucune technologie grand public n'avait connu : plusieurs noms par trimestre, chacun présenté comme « le plus puissant jamais créé ».
Pour un dirigeant de PME, la question est légitime : ces sorties correspondent-elles à de réelles modifications majeures, ou sert-on plus de marketing que d'ingénierie pour justifier des tarifs croissants ? La réponse est nuancée, et c'est précisément ce que cet article décrypte, données à l'appui, pour vous aider à ne pas payer plus cher un simple changement d'étiquette.
2. Derrière les noms : une innovation réelle, mais incrémentale
Les observateurs indépendants confirment que les modèles de tête convergent. Selon le suivi d'Artificial Analysis, l'indice composite de performance plafonne à 57 depuis la preview de Gemini 3.1 Pro en février 2026 : GPT-5.4 l'a rejoint en mars, et Claude Opus 4.7 prolonge son avance en code et en agents sans franchir le plafond. En clair : chaque laboratoire sprinte, aucun ne creuse l'écart.
Cette stagnation des classements ne signe pas l'arrêt du progrès : il devient plus fin. Depuis 2019, les fenêtres de contexte ont gagné environ trois ordres de grandeur, passant de quelques milliers de tokens à plusieurs millions — une base de code entière tient désormais dans une seule session. Le rapport Vellum parle de « redlining » des capacités, et Ilya Sutskever, cofondateur d'OpenAI, annonce la fin de l'ère du simple scaling. L'innovation continue, mais par paliers mesurés — et l'open source, comme Qwen 3.8, rattrape les modèles propriétaires.
Le constat
Depuis février 2026, l'indice composite des modèles de tête plafonne à 57. Les noms changent toutes les semaines ; les capacités, elles, progressent par paliers.
3. Vrai saut, amélioration ou rebranding : comment les distinguer
Tous les lancements ne se valent pas. Un saut générationnel change l'architecture ou le raisonnement : GPT-5, dont la sortie en août 2025 a « créé une onde de choc », ou Gemini 3, première génération pensée pour le très long contexte, en sont des exemples documentés. Une amélioration incrémentale affine le même modèle : les versions 4.6 puis 4.7 de Claude Opus grappillent des points au classement sans bouleverser l'usage.
Enfin, les variantes « mini », « flash » ou « turbo » distillent un modèle existant pour le rendre moins cher et plus rapide : utiles en production, ce ne sont pas des avancées. Certains paliers relèvent même du pur positionnement, comme le tier « Mythos » de Claude Fable 5, jugé inutile pour une PME généraliste par l'analyse EvoLab. Le nom ne dit rien de la nature du changement : il faut regarder les données.
4. Pourquoi les laboratoires multiplient-ils les noms ?
La multiplication des noms répond d'abord à une logique économique : chaque palier justifie un palier de prix, un abonnement ou une facture API plus élevée. Elle répond ensuite à une logique concurrentielle spectaculaire : quand Marc Benioff, patron de Salesforce, annonce abandonner ChatGPT pour Gemini 3, l'action d'Alphabet grimpe de plus de 6 %, et Sam Altman confie redouter des « vents contraires temporaires », rapporte Yahoo Finance.
Cette course a des effets mesurables sur les entreprises : 62 % des organisations testent encore des agents IA sans passer à l'échelle, et les benchmarks de référence se saturent — des modèles approchent 76 % sur SWE-bench Verified par reconnaissance de motifs plutôt que par raisonnement réel, souligne Vellum. À force de comparer des scores qui convergent, on oublie l'essentiel : quel modèle gagne sur votre cas d'usage concret.
5. Payer plus cher à chaque nouveau nom : est-ce vraiment nécessaire ?
Le réflexe « dernier modèle, meilleur investissement » coûte cher, car les éditeurs segmentent eux-mêmes leur gamme. Claude Sonnet 5, sorti fin juin 2026, affiche des performances proches de l'Opus 4.8 pour un coût nettement inférieur : le rapport qualité-prix devient un argument commercial aussi fort que la performance brute, note EvoLab. Côté acheteurs, le coût est remonté dans les premiers critères de décision, avec la sécurité et la conformité.
Le marché confirme cette maturité : l'IA agentique est passée d'environ 5,4 milliards de dollars en 2024 à 7,6 milliards en 2025, pour viser près de 47 milliards en 2030, et 88 % des dirigeants prévoient d'augmenter leur budget IA, principalement pour déployer des agents. Une PME n'a pas besoin du modèle le plus puissant, mais du bon modèle pour chaque tâche, au bon prix : c'est exactement ce qu'un simulateur d'économies permet de chiffrer avant d'acheter.
6. Vérifier qu'un modèle est vraiment meilleur : la méthode
Avant d'adopter — et de payer — une nouvelle version, mesurez sur vos données plutôt que sur les communiqués. Quatre réflexes simples :
- Tester sur cinq à dix cas réels de votre métier, pas sur un benchmark générique ;
- Comparer coût par tâche, latence et fiabilité, pas le score mis en avant par l'éditeur ;
- Croiser les classements indépendants (Artificial Analysis, LMArena) avec vos propres essais ;
- Re-mesurer tous les trois mois : le « meilleur » modèle d'aujourd'hui peut être dépassé — et moins cher — demain.
Cette méthode, nous l'appliquons à chaque projet Tchatix : notre plateforme embarque plus de trente modèles et cinq cents connexions vers vos outils métier, et nous changeons le modèle sous-jacent d'un agent sans toucher à son interface dès qu'une alternative plus performante arrive. Cette agilité vaut mieux que la fidélité à un nom — un point qu'un expert peut détailler avec vous en un échange.
💡 Verdict Tchatix
L'innovation des modèles d'IA est réelle, mais incrémentale : la plupart des nouveaux noms traduisent des gains modestes, pas des révolutions. Le bon réflexe n'est pas de payer plus à chaque sortie, mais d'arbitrer le meilleur rapport qualité-prix pour chaque usage — et de pouvoir changer de modèle dès qu'un concurrent fait mieux. Les entreprises qui gardent cette flexibilité captent les bénéfices de la course sans en payer le prix marketing.
7. FAQ : modèles d'IA, marketing et prix
Un nouveau modèle d'IA sort-il vraiment toutes les deux ou trois semaines ? Non : les sauts majeurs restent annuels (GPT-5, Gemini 3, Opus 5). Ce qui s'accélère, c'est le nombre de déclinaisons et de versions intermédiaires. L'impression de cadence vient du nombre de noms, pas du nombre de révolutions.
GPT-5 mini, Flash ou Sonnet sont-ils de vrais nouveaux modèles ? Ce sont des versions distillées d'un modèle existant : mêmes capacités de fond, coût et latence réduits. Utiles pour industrialiser un agent, elles ne constituent pas une avancée scientifique — malgré un habillage marketing complet.
Faut-il payer plus cher dès qu'un modèle plus récent sort ? Non : les éditeurs alignent des paliers intermédiaires « proches du haut de gamme, à coût inférieur », et le prix par token des gammes d'entrée ne cesse de baisser. Mesurez le coût par tâche, pas la date de sortie.
Quels critères pour choisir un modèle d'IA en entreprise ? Le cas d'usage d'abord : raisonnement, code, long contexte, sécurité. Croisez ensuite benchmarks indépendants, tests sur vos données et coût total par tâche — en conservant la possibilité de changer de modèle sans refaire l'intégration.
La course aux modèles n'est ni un mirage ni une pure opération marketing : elle produit des gains réels mais incrémentaux, de plus en plus difficiles à mesurer à l'œil nu. Le vrai changement de 2026 n'est pas le nom sur l'étiquette, mais la capacité des entreprises à brancher, comparer et permuter les meilleurs modèles selon leurs tâches.
C'est la logique des agents que Tchatix conçoit pour les PME et ETI : choisir automatiquement le bon modèle, au bon coût, pour chaque demande, avec hébergement OVHcloud en France, conformité RGPD et un support humain six jours sur sept. Une approche multi-modèles construite avec l'écosystème Bpifrance et France 2030, pensée pour durer.
Cet article a été rédigé par notre Agent SEO Tchatix, puis relu et validé par notre équipe éditoriale. Les sources citées sont vérifiables dans les liens hypertextes du texte.
Articles liés

IA et QHSE en PME : automatiser audits, DUERP et prévention des risques en 2026
DUERP, audits, presque-accidents, contrôle qualité : comment les agents IA transforment le management QHSE des PME en 2026, sans remplacer le jugement humain.

IA et paie en 2026 : comment les agents IA automatisent bulletins, variables et DSN des PME
La paie française cumule plus de 4 000 conventions collectives et une DSN mensuelle à produire au jour près. En 2026, les agents IA automatisent collecte des variables, contrôles et bulletins — avec des erreurs réduites de près de 50 %.

IA et publicité en ligne en 2026 : comment les PME pilotent Google Ads et Meta Ads avec des agents IA
Google Ads et Meta Ads sont devenus trop complexes pour un pilotage 100 % manuel. En 2026, les agents IA prennent en charge enchères, créatifs et reporting : le guide pratique des PME pour automatiser sans perdre le contrôle.
Déployez votre propre Agent SEO
Le même agent peut rédiger votre stratégie de contenu. Réservez un audit gratuit.